

...
分析データの粒度はより細かく データ分析講座(その164)
◆ 分析は最終的かつ不可逆的なもの
蓄積され続けてはいるけど、人手にあまり触れられていないデータの中には、データの粒度がバラバラなケースが多々みられます。そのようなデータを相手に集計や分析を行うと非常に苦労します。ちなみに、データの粒度とはデータの細かさの程度をいいます。分かりやすくお話すると時間やカテゴリー、エリアなどです。例えば時間の粒度がバラバラとは、あるデータは日単位で、あるデータは月単位であるということです。
カテゴリーの粒度がバラバラとは、エリアや時期によってデータとして蓄積されているカテゴリーが異なったり(ある時期は大カテゴリーまでのデータしかない、など)、カテゴリーの分け方(考え方)が異なるということです。
今回は「分析は最終的かつ不可逆的なので、データの粒度はより細かく」というお話しをします。
【目次】
- 加工は「不可逆的」
(1)粗い粒度を細かくできない
(2)モデルを構築した時、使用した学習データは、モデルからは分からない
(3)覆水盆に返らず - データの粒度はより細かく蓄積しておこう
- 今回のまとめ
1. 加工は「不可逆的」
不可逆的とは、加工する(手を加える)と元に戻せない性質のことを意味します。例えば、工場で物を生産するとき、機械などで加工しますが、一度材料などに手を加えると元の状態に戻すことができなくなります。データの集計や分析なども同様です。
(1)粗い粒度を細かくできない
1日単位のデータを1ケ月単位に集計するなど、細かい粒度のデータを粗くすることは可能です。しかし逆は非常に難しくなります。要するに、粗い粒度を細かくできないのです。
(2)モデルを構築した時、使用した学習データは、モデルからは分からない
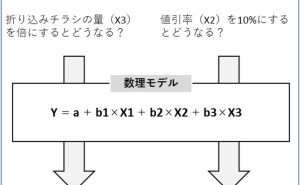
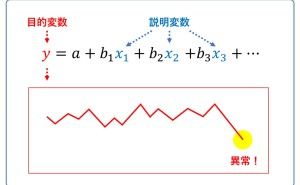
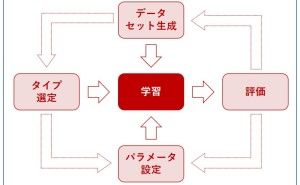
データ分析・活用をビジネスで実施しようとする時、異常検知や予測モデルなどを構築することはあります。これらモデルを構築するためにはデータが必要になります。そのようなデータを、学習データといいます。当然ですが、モデルを構築した時に使用した学習データは、モデルからは分かりません。
(3)覆水盆に返らず
データ分析も最終的かつ不可逆的なため、後から粒度の粗いデータを細かくできないし、構築されたモデルから学習データを作ることはできません。要するに「覆水盆に返らず」です。もし、データの粒度が粗い状態で蓄積されていたら最終的かつ不可逆的と諦(あきら)め、その範囲でどうにかして、データ分析・活用をしなければなりません。
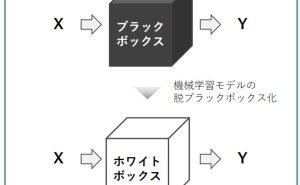
ブラックボックス化された異常検知や予測モデルなどを使うのであれば最終的かつ不可逆的と諦め、その状態でデータ分析・活用をしなければなりません。つまり、取り返しがつかないということです。ここで悩んでも仕方がないので、現状でどうにかする必要があります。さらに、今後悩まないように、データ分析も最終的かつ不可逆的であることを前提に、データ分析・活用を考えていく必要はあります。
2. データの粒度はより細かく蓄積しておこう
可能ならば、データの粒度はより細かく蓄積しておいたほうがいいでしょう。
今不必要な粒度でも、将来必要な粒度になることはあります。また、利用している数理モデルを構築した時の学習データなども残しておきましょう。その時学習データだけでなく、どのように学習させたかという条件設定や、そこに至るまでのフローなども残しておいたほうがいいでしょう。残念なことに、数理モデルを構築したときの学習データと思われるもので、数理モデルを再構築したのに再現できない、ということがたまにあります。
3. 今回のまとめ
今回は「データの粒度はより細かく、なぜならばデータ分析は最終的かつ不可逆的だから」というお話しをしました。
それなりのデータ分析をしたことのないデータの場合、データの粒度がバラバラで苦労することがあります。データの粒度とは、文字通りデータの細かさの程度をいい、時間やカテゴリー、エリアなどです。例えば、1日単位のデータを、1ケ月単位に集計するなど、細かい粒度のデータを粗くすることは可能です。データ分析は最終的かつ不可逆的なため、集計したものや構築したモデルから元データを得ることはできません。
実際に、1ケ月単位のデータを、1日単位のデータにすることは、非常に無理があります。もし、データの粒度が粗い状態で蓄積されていたら最終的かつ不可逆的と諦め、その範囲でどうにかし、データ分析・活用をしなければなりません。ブラックボックス化された異常検知や予測モデルなどを使うのであれば最終的かつ不可逆的と諦め、ブラックボックス化された状態でデータ分析・活用をしなければなりませんので、その現状でどうにかする必要があります。
さらに今後悩まないよう、データ分析も最終的かつ不可逆的であることを前提に、データ分析・活用を考えていく必要があります。可能ならば、データの粒度はより細かく蓄積しておいたほうがいいでしょう。
次回に続きます。
続きを読むには・・・
この連載の他の記事
現在記事
分析データの粒度はより細かく データ分析講座(その164)
「情報マネジメント一般」の他のキーワード解説記事
もっと見る
データサイエンス波及の5つのポイント データ分析講座(その122)
◆ データサイエンス、小さく始め大きく波及 データサイエンス・ 機械学習・ AIと、夢を大きく持つことはいいことですが、足下無視で進めることはでき...
◆ データサイエンス、小さく始め大きく波及 データサイエンス・ 機械学習・ AIと、夢を大きく持つことはいいことですが、足下無視で進めることはでき...
営業データ分析の良し悪しとは データ分析講座(その8)
◆ 営業データ分析の事始めは、「見える化」で失敗し「指標作り」で成功する 「どのようなデータを集めれば、営業力を上げられるのか」こ...
◆ 営業データ分析の事始めは、「見える化」で失敗し「指標作り」で成功する 「どのようなデータを集めれば、営業力を上げられるのか」こ...
PPDACサイクルとは データ分析講座(その124)
◆ 小さくデータサイエンスを始めるならPPDACサイクル データとドメイン(営業・マーケティング・生産・経営などの現場)を結びつけ、データサイエン...
◆ 小さくデータサイエンスを始めるならPPDACサイクル データとドメイン(営業・マーケティング・生産・経営などの現場)を結びつけ、データサイエン...
「情報マネジメント一般」の活用事例
もっと見る
‐時代の流れを意識した開発テ-マの設定‐ 製品・技術開発力強化策の事例(その5)
前回の事例その4に続いて解説します。時代の流れに沿う開発テ-マとして、最近では、高齢者介護機器、環境関連機器、省エネ機器、情報技術(IT)等に関心が注が...
前回の事例その4に続いて解説します。時代の流れに沿う開発テ-マとして、最近では、高齢者介護機器、環境関連機器、省エネ機器、情報技術(IT)等に関心が注が...
‐社内の問題克服による開発活動‐ 製品・技術開発力強化策の事例(その14)
前回の事例その13に続いて解説します。社内における様々な問題を高いレベルで深く追及して解決することが、競争力のある技術を育成し、売れる製品を生み出す事に...
前回の事例その13に続いて解説します。社内における様々な問題を高いレベルで深く追及して解決することが、競争力のある技術を育成し、売れる製品を生み出す事に...
Excelの帳票を見直そう
オフィス業務においては、マイクロソフトOfficeがデファクトスタンダードになっています。とりわけ活用されているのはExcelでしょう。Excelを使う...
オフィス業務においては、マイクロソフトOfficeがデファクトスタンダードになっています。とりわけ活用されているのはExcelでしょう。Excelを使う...







